GUIDE · PRÉDICTIONS PROBABILISTES
Probabilités 1N2 : pourquoi une prévision doit être calibrée
BetGPT · 19 novembre 2026 · Guide éducatif indépendant
Un modèle peut choisir souvent la bonne équipe et pourtant attribuer de mauvaises probabilités. Ce guide explique ce que signifient les trois issues 1N2, pourquoi les cotes ne sont pas des probabilités nettes et comment vérifier une prédiction avec des contrôles reproductibles.
Le pronostic gagnant n’est pas la meilleure mesure
Sur une rencontre de football, choisir correctement le résultat le plus probable donne une information limitée. Un modèle qui annonce une victoire à 51 % et un autre à 85 % peuvent sélectionner la même équipe, alors qu’ils décrivent des niveaux d’incertitude très différents. Si le match se termine autrement, leur erreur probabiliste ne devrait pas être évaluée de façon identique. L’objectif scientifique est de juger la qualité des probabilités sur une série de matchs indépendants, plutôt que de mettre en avant un résultat spectaculaire. Une décision isolée ne permet pas de conclure que le système est fiable. Les distributions 1N2 sont des estimations, pas des certitudes ou des invitations à engager de l’argent.
Que signifient 1, N et 2 ?
La notation 1N2 correspond à trois issues distinctes dans le temps réglementaire, sous réserve des règles explicites de la compétition et du marché considéré : victoire de l’équipe qui reçoit, match nul et victoire de l’équipe visiteuse. Pour être cohérente, une prédiction probabiliste doit attribuer à ces trois issues des nombres entre zéro et un, dont la somme est égale à un. On peut par exemple annoncer 45 % pour 1, 29 % pour N et 26 % pour 2. Ce trio n’affirme pas que le match sera gagné à domicile. Il indique qu’une victoire à domicile est l’issue jugée la plus probable, tout en conservant 55 % de probabilité cumulée pour les deux autres résultats. La nuance est essentielle.
Une cote décimale n’est pas une probabilité nette
Une cote décimale est généralement affichée sous une forme qui inclut la marge commerciale de l’opérateur. Son inverse permet de calculer une probabilité implicite brute : 1 divisé par la cote. À titre d’exemple pédagogique et non de cote réelle, les cotes 2,00, 3,50 et 4,00 donnent environ 50 %, 28,57 % et 25 %. Leur somme vaut environ 103,57 %, pas 100 %. Cet excédent s’appelle souvent la surcote du marché, ou overround. Il ne suffit donc pas de juxtaposer les trois inverses et de les appeler directement les probabilités réelles d’un match. Les hypothèses commerciales et les différentes façons de répartir la marge comptent.
Retirer la marge avec prudence
Une normalisation élémentaire consiste à diviser chacune des probabilités implicites brutes par leur somme. Pour l’exemple théorique précédent, cela produit environ 48,3 % pour 1, 27,6 % pour N et 24,1 % pour 2. Cette transformation rend la somme égale à 100 %, mais elle repose sur l’hypothèse que la marge peut être répartie proportionnellement. Rien ne prouve qu’un opérateur applique réellement cette méthode ni que le résultat reflète une vérité statistique. Plusieurs marchés et méthodes peuvent produire des distributions différentes. Le but de cet exercice est de comprendre ce qu’une cote contient et ce qu’elle ne révèle pas. Il ne démontre aucun avantage économique et ne fournit aucun conseil de mise.
La calibration : comparer 60 % à ce qui se passe vraiment
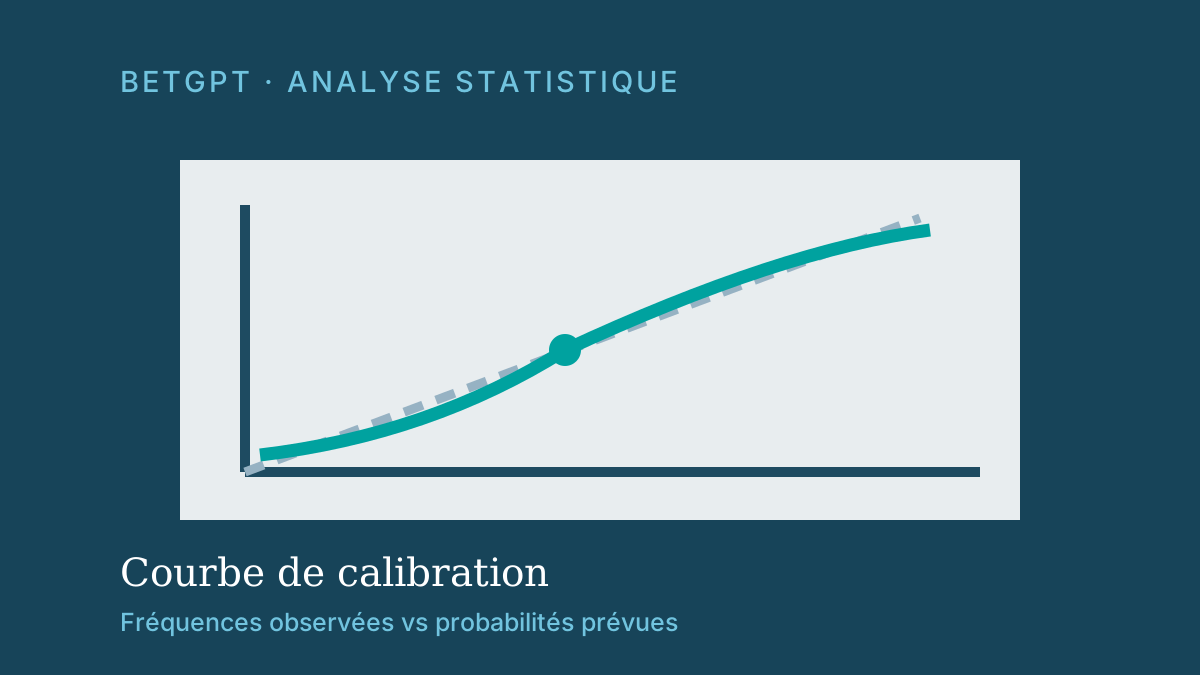
Un modèle est bien calibré si, sur un grand ensemble d’événements auxquels il attribue des probabilités comparables, les fréquences observées sont cohérentes avec ces probabilités. Si des victoires à domicile prévues autour de 60 % surviennent très rarement, il faut examiner un possible excès de confiance. La comparaison doit tenir compte du nombre de matchs et des fluctuations aléatoires : 10 observations ne permettent pas les mêmes conclusions que 1 000. Les courbes de calibration, appelées reliability diagrams, regroupent les estimations en tranches et affichent la fréquence effective dans chaque tranche. La documentation scikit-learn décrit cette démarche pour les modèles de classification.
Évaluer les trois classes séparément
Le résultat 1N2 n’est pas un problème binaire classique. Une équipe peut gagner, faire match nul ou perdre : mesurer seulement la probabilité de victoire du favori élimine une partie importante de l’information. Il faut contrôler la calibration des probabilités de 1, de N et de 2, puis examiner si elles restent cohérentes ensemble. Les nuls posent souvent un défi particulier parce qu’ils sont moins fréquents dans certains échantillons et dépendent de la ligue, des équipes et de la période. Un écart systématique entre la fréquence des nuls et leur probabilité annoncée mérite d’être conservé comme résultat défavorable, et pas corrigé silencieusement dans le compte rendu.
Le score de Brier juge une distribution probabiliste
Le score de Brier compare les probabilités annoncées aux résultats réellement observés. Dans une formulation multiclasses, on additionne pour chaque match les carrés des écarts entre les trois probabilités prédites et les indicatrices de l’issue constatée, puis on moyenne sur les matchs. Le score dépend de la convention d’échelle utilisée ; les comparaisons doivent donc employer exactement la même définition. Un score plus petit indique une meilleure précision selon cette mesure, mais il ne décrit pas à lui seul la qualité des explications ni la stabilité future. Le Brier doit être comparé à des méthodes de référence simples sur le même échantillon chronologique, et non présenté isolément comme un label de supériorité.
La log-loss pénalise l’excès de certitude
Une autre mesure usuelle est la perte logarithmique, ou log-loss. Si un système attribue une probabilité infime au résultat qui survient finalement, il reçoit une pénalité importante. Cette propriété aide à détecter les probabilités trop extrêmes, mais rend aussi la métrique sensible à la qualité de l’estimation des faibles probabilités. Les résultats doivent être présentés avec leur définition, le périmètre et la date du jeu d’essai. Un modèle peut obtenir un bon score sur une période et perdre cette qualité après un changement de championnat, d’effectif ou de style de jeu. Il faut donc éviter de confondre ajustement rétrospectif et performance prédictive durable.
Pourquoi séparer entraînement, calibration et test
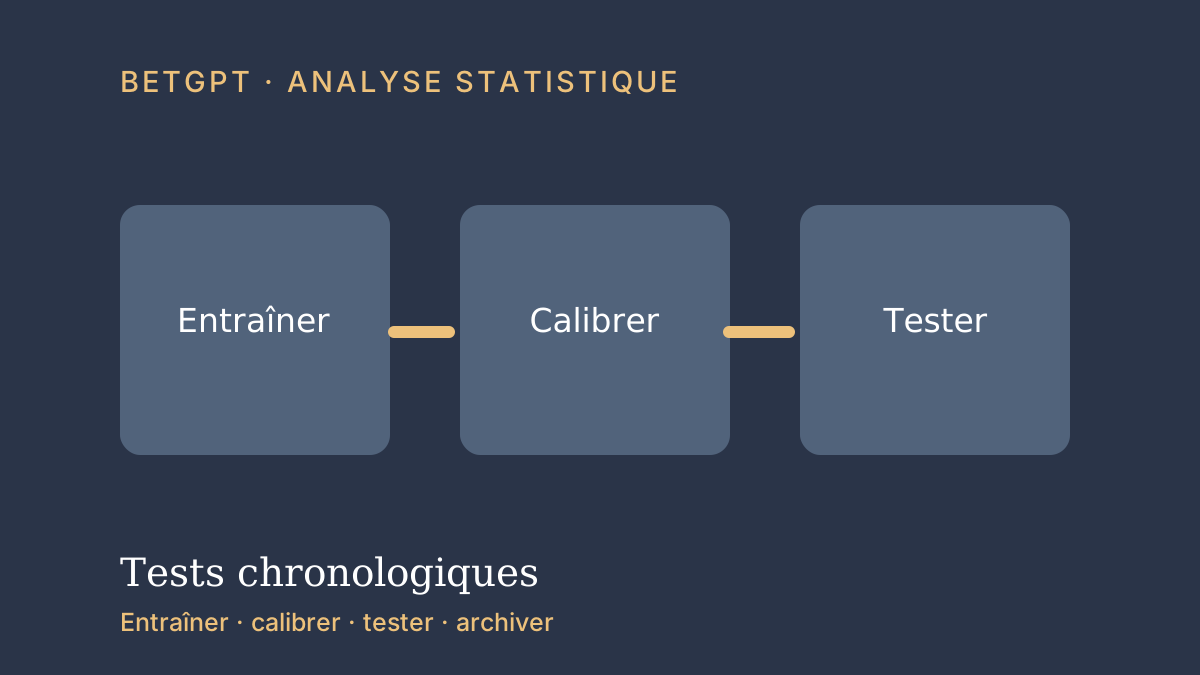
En football, les données sont temporelles. Mélanger au hasard tous les matchs de plusieurs années peut introduire une fuite d’information, notamment si des variables ont été construites avec des résultats futurs ou des classements définitifs. Une procédure prudente entraîne le modèle sur une période ancienne, ajuste éventuellement sa calibration sur une période distincte, puis évalue une période ultérieure jamais utilisée. Les variables disponibles au moment exact de la prévision doivent être archivées. Les données corrigées après coup ne doivent pas être présentées comme si elles avaient été disponibles avant le coup d’envoi. La documentation scikit-learn précise également que les données utilisées pour ajuster le calibrateur doivent être distinctes de celles qui servent à entraîner le classifieur.
Comparer avec des références simples
Un modèle complexe ne mérite pas d’être retenu simplement parce qu’il possède davantage de paramètres. On doit le comparer à des probabilités de base : fréquences historiques d’une compétition, modèle utilisant seulement l’avantage du terrain ou méthode volontairement simple. Les mêmes matchs, les mêmes conventions de résultat et les mêmes périodes doivent s’appliquer à toutes les méthodes. Il faut annoncer à l’avance les métriques et les conditions de succès afin d’éviter de sélectionner après coup le seul chiffre favorable. Un contrôle négatif, tel qu’une permutation des résultats ou un prédicteur constant, peut révéler qu’un pipeline obtient par erreur une performance flatteuse. Ces tests sont des outils de vérification, pas une garantie de bénéfice.
Lire correctement un graphique de fiabilité
Dans un diagramme de calibration, l’axe horizontal porte la probabilité moyenne annoncée et l’axe vertical la fréquence réelle observée. La diagonale est un repère idéal, pas un chemin que toute courbe suivra parfaitement. Les points situés nettement sous la diagonale peuvent correspondre à un excès de confiance ; ceux au-dessus à une sous-estimation. Mais un diagramme sans les effectifs par tranche peut être trompeur. Il est important de représenter les intervalles d’incertitude et d’éviter les tranches contenant seulement quelques matchs. Un graphique réaliste doit garder les irrégularités plutôt que lisser artificiellement des résultats défavorables.
Ce qu’une analyse honnête peut conclure
Une évaluation reproductible devrait fournir les identifiants ou dates des matchs, l’instant de prévision, les probabilités 1N2, les résultats observés, les règles de traitement des matchs annulés et les scores des baselines. Elle doit préciser si l’étude est rétrospective, prospective ou menée en production. Un test local du logiciel établit que le code s’exécute ; il ne valide pas une capacité prédictive sur de nouveaux matchs. Une moyenne de succès ou un diagramme flatteur ne suffit pas à prouver une rentabilité, laquelle dépendrait aussi des cotes réellement disponibles, des frais, des restrictions et du risque. BetGPT présente ici une méthode de lecture critique des probabilités, sans proposer de pari particulier.
Sources méthodologiques
- Scikit-learn — Probability calibration
- Scikit-learn — Calibration curves, example
- Scikit-learn — Model evaluation, Brier score and log loss
Les valeurs chiffrées du texte sont des illustrations fictives, non des cotes observées ou des résultats réels.